《Mousika 规则引擎:让规则可编排、可执行、可解释》 介绍了规则编排与脚本计算分层的设计。本次在 Mousika 基础上继续升级,引擎名称统一为 Mosika,核心升级集中在三个方面:丰富内核层、增强 UI 表示层、提供真正可操作的 UI 界面。
| 升级方向 | 本次变化 | 带来的价值 |
|---|---|---|
| 丰富内核层 | 新增 SomeNode、AnyNode、AllNode 和 LoopNode,支持规则模板与节点参数 |
表达更丰富的条件与循环策略,让一份业务逻辑按需复用 |
| 增强 UI 表示层 | 扩展 Flow / Rule 递归节点模型,适配内核能力,贯通 UI AST 编译与执行路径映射 | 将复杂策略组织为可编辑、可持久化、可关联执行结果的结构 |
| 提供真正的 UI 界面 | 提供流程编排、规则编排、JS 函数与 UDF 管理、在线测试等可操作页面 | 让用户在界面中完成规则配置、能力管理和运行验证 |
内核计算实现也在这次升级中从 GraalJS 切换为 Rhino,并开展压测实验。综合评估后的引擎选择通过集中的适配与绑定接入,后续仍可按需替换。
UI 表示层定义“界面如何表达规则”,UI 界面让用户实际完成规则操作。 前者用节点模型、编译和路径映射衔接内核,后者把这些结构呈现为画布、配置面板和测试结果。两层配合,内核新增的能力才能完整地进入用户的编排与验证过程。
Mosika 延续双层语言分工:规则 ID DSL 决定执行哪些规则、如何组合,JavaScript 决定每条原子规则算什么。 在此基础上,内核提供更丰富的执行能力,UI 表示层承接这些能力,实际界面把它们交到使用者手中。
一、为什么把编排与计算分开
编排语言处理组合关系,计算语言处理业务值,二者需要稳定的连接方式。
以“校验输入后并行收集两类数据,最后记录结果”为例,结构层只需要表达:
a->(b=>c)->d
其中 a、b、c、d 是规则 ID。-> 表示串行,=> 表示并行:正常执行时,先执行 a,再等待 b、c 都完成,最后执行 d。每条规则背后是素材校验、数据查询还是 UDF 调用,不影响这段编排的解析。
| 层 | 语言 | 职责 |
|---|---|---|
| 结构层 | 规则 ID DSL | 与或非、命中数、条件、串行、并行、有界循环 |
| 计算层 | JavaScript | 读取业务对象、调用 UDF、计算业务返回值 |
| 连接契约 | 规则 ID、运行时绑定、结果模型 | 查找规则、传入数据、把求值结果交给控制结构 |
把 JavaScript 嵌入流程配置并非不可行:可以把脚本作为独立字符串交给另一套解析器,也可以在同一配置对象中保留规则 ID。Mosika 选择单独管理规则定义,是为了让结构解析器只处理组合语法,并让画布节点、规则库和执行详情都能引用稳定的业务单元。
规则定义与产品编排分别维护
一条原子规则由 RuleDefinition 保存规则 ID、表达式和描述。规则生产侧负责它的业务语义与测试;产品侧用规则 ID 组合流程,为不同节点提供参数。
本文的界面截图统一使用默认命名空间下的“素材补全重试”(f20101,V2 演示草稿),依次展示规则定义、复合条件、流程编排和同一版本的试运行。串并行及分支语法另用简化示意图说明。界面截图可点击打开原图,再点击放大查看节点与参数。
例如,该场景引用的“仍需补全素材”(r10201)在规则库中定义为:
($$.get("sourceRetryCount") || 0) < $.requiredSourceRetries
表达式比较当前重试计数与输入要求,流程节点只保存规则引用。后文将沿着这个条件查看复合编排,再验证动作更新计数后,下一轮判断如何改变。
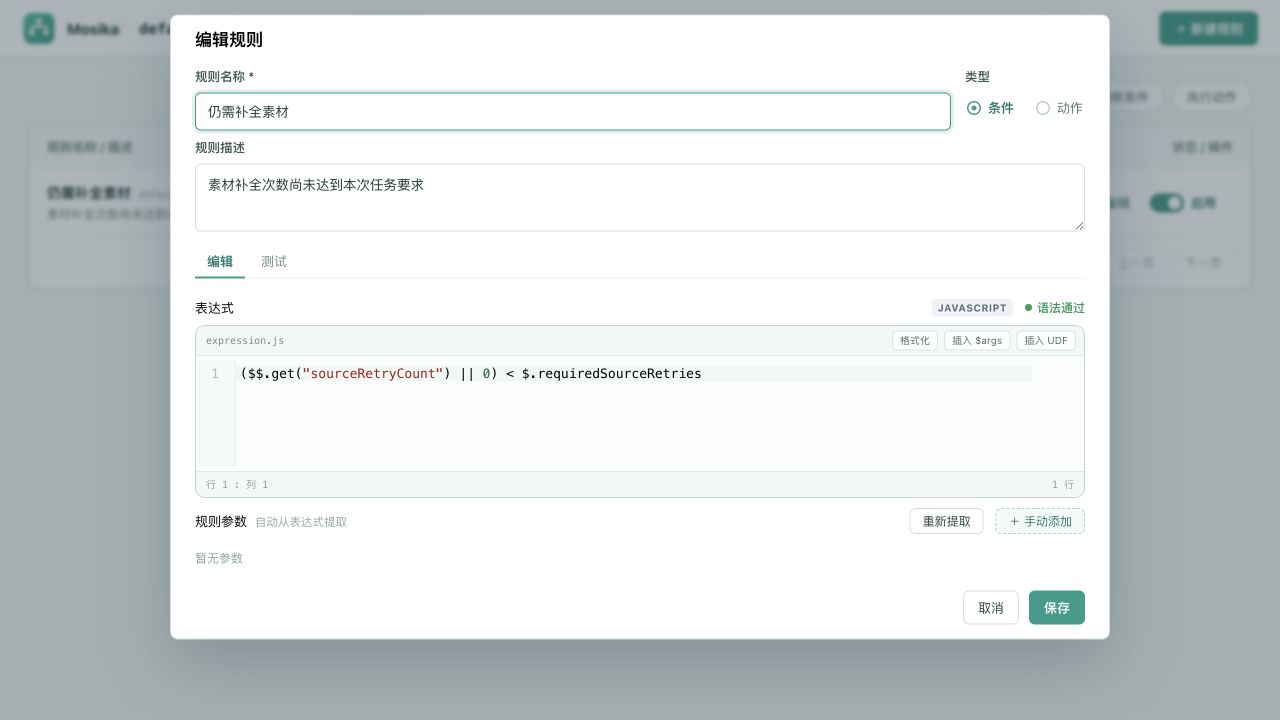
规则 ID 把业务能力沉淀为可引用的单元:规则侧维护计算逻辑,产品侧组合策略、配置参数,并通过试运行检查效果。一份规则定义可以服务多个场景,避免为每条流程重复编写脚本。
二、递归树如何表达编排
递归树把汇合与循环体边界封装在结构节点里,用户无需单独配置汇合节点和循环回边。
自由连线的流程图依靠边表达执行关系。并行分支如何汇合、回边围住哪些节点,需要在模型中有明确表示。带循环回边的图是有向图,不能再称为 DAG;DAG 本身无环,也可以把循环封装在一个任务节点内部。
Mosika 的选择是让每个结构节点直接包含自己的子树。并行节点持有分支,循环节点持有条件和循环体,边界由父子关系确定。引擎仍然负责等待分支完成、逐轮判断和退出,只是这些机制不再要求用户用自由连线来配置。
两个递归域:Flow 与 Rule
UI 模型有两个相互连接的递归域。以下是简化的类型定义,其中 expr 保存规则 ID 引用,next 在循环节点上表示循环体:
Flow = ActionNode(rule, next?)
     | ConditionNode(rule, next?)
     | SerialNode(Flow+)
     | ParallelNode(Flow+)
     | DecisionNode(ConditionNode+, default?)
     | LoopNode(max, rule, next)

Rule = AtomicNode(expr, args?)
     | BooleanNode(expr, args?, negative)
     | LogicNode(&& | ||, Rule+)
     | MatchNode(minHits, maxHits, Rule+)
Flow:承载动作、条件、串行、并行、分支和循环的流程域。
Rule:嵌入流程节点的规则表达式域,承载原子引用、取反、与或组合和命中数约束。
两者通过 FlowNode.rule 单向连接,Rule 子树不能反向包含 Flow 节点。例如,“素材补全重试”的 V2 演示草稿把请求完整、预算充足、仍需重试与素材缺口组合成循环条件,内部继续嵌套与、或、取反及限定匹配:
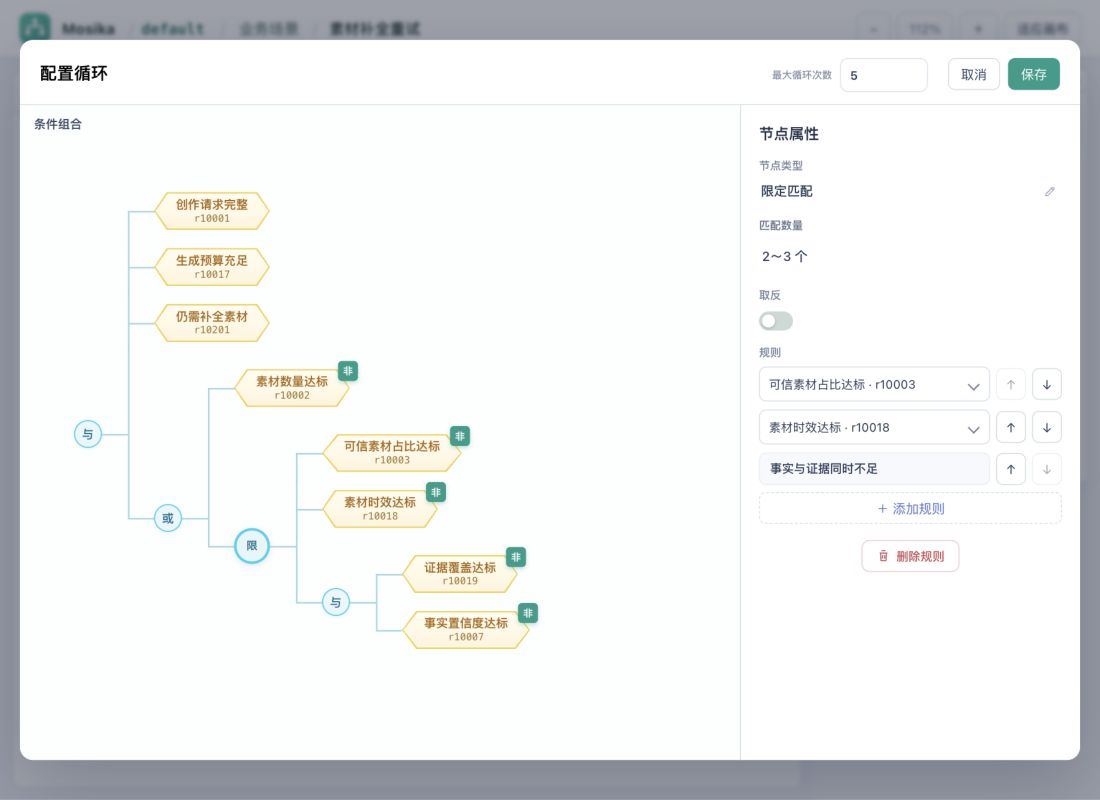
其中,“限”统计三个直接子条件的命中数:可信素材占比不足、素材时效不足,以及“证据覆盖不足且事实置信度不足”这一复合条件。最后一项内部有两个判断,但整体只计一次命中,体现了 Rule 子树可以递归组合。
边界由节点持有
ParallelNode 的每个分支都是完整的 Flow 子树,正常完成需等待所有分支结束;执行错误或等待超时则向调用方报告异常。LoopNode.next 是循环体,可以包含串行、并行或另一个循环节点。嵌套循环沿用相同的父子结构,不需要再解释一组回边的范围。
下面用“并行执行 b、c,完成后在条件 cond 命中时重复 L,最多 N 轮”比较两种表达。上半图的箭头表示执行方向;下半图的连线表示内核树的包含关系,串行子节点用序号表示顺序。
| 维度 | 自由连线的流程图 | 递归树 |
|---|---|---|
| 并行汇合 | 用连线及汇合规则表达 | 由并行节点等待自己的分支 |
| 循环范围 | 回边、循环区域或专门节点 | 循环体是一棵明确的子树 |
| 执行语义 | 由图模型定义,不必依赖坐标 | 由节点类型与子节点顺序定义 |
| 嵌套组合 | 按图模型组织连接与分组 | 每棵子树都能继续组合条件和流程 |
| 编辑与执行 | 可以采用不同表示 | 同样采用 UI AST 与内核树两种表示 |
递归树适合组织为嵌套块的业务策略。两条独立依赖链可以直接写成 (A->C)=>(B->D),每条分支内部保持顺序,两条分支并行推进;素材补全场景则把多层质量条件嵌入循环,再把循环接入串行流程。每个局部都沿用相同的组合方式,复杂策略因此可以逐层构建。
DSL 算子与内核节点
| 语法 | 内核节点 | 语义 |
|---|---|---|
!a |
NotNode |
对命中状态取反 |
a&&b |
AndNode |
按顺序求值,遇未命中即短路 |
a||b |
OrNode |
按顺序求值,遇命中即短路 |
all(a,b,c) |
AllNode |
复用与语义,保留独立节点身份 |
any(a,b,c) |
AnyNode |
复用或语义,保留独立节点身份 |
some(2,_,a,b,c) |
SomeNode |
至少命中两条,能提前确定结果时短路 |
a?b:c / a?b |
CaseNode |
根据 a 的命中状态选择分支 |
a->b |
SerNode |
按声明顺序执行 |
a=>b |
ParNode |
并行执行并等待完成 |
loop(3,cond,act) |
LoopNode |
每轮先判断 cond,最多执行三轮 act |
_ |
命中数边界 | 该侧不限制 |
∅ |
结构占位 | 稳定串并结构,不承载业务计算 |
下面三张图只展示执行方向,不表示 UI AST 的父子关系。串行逐个执行并等待;并行先提交各分支,再等待整组完成:
条件分支依据 matched 选择。有序多分支只继续判断尚未命中的后续条件,不会并行尝试所有分支:
有界循环每轮先判断条件,条件未命中或轮次达到上限时退出。达到上限后不会再额外求值一次条件:
回到同一个“素材补全重试”场景:外层串行节点先执行最多 5 轮的循环,再执行“记录生成审计”;循环每轮使用上文的复合条件决定是否执行 r10202。左侧流程与右侧条件树通过选中的循环节点对应起来。
本例使用模拟动作展示状态推进:r10202 仅增加 $$ 中的 sourceRetryCount 并返回阶段对象,不执行真实素材检索,也不改变素材质量指标;“记录生成审计”r10128 同样只返回演示结果,不持久化审计记录。素材缺口持续存在时,循环依靠重试计数或最大轮数退出。
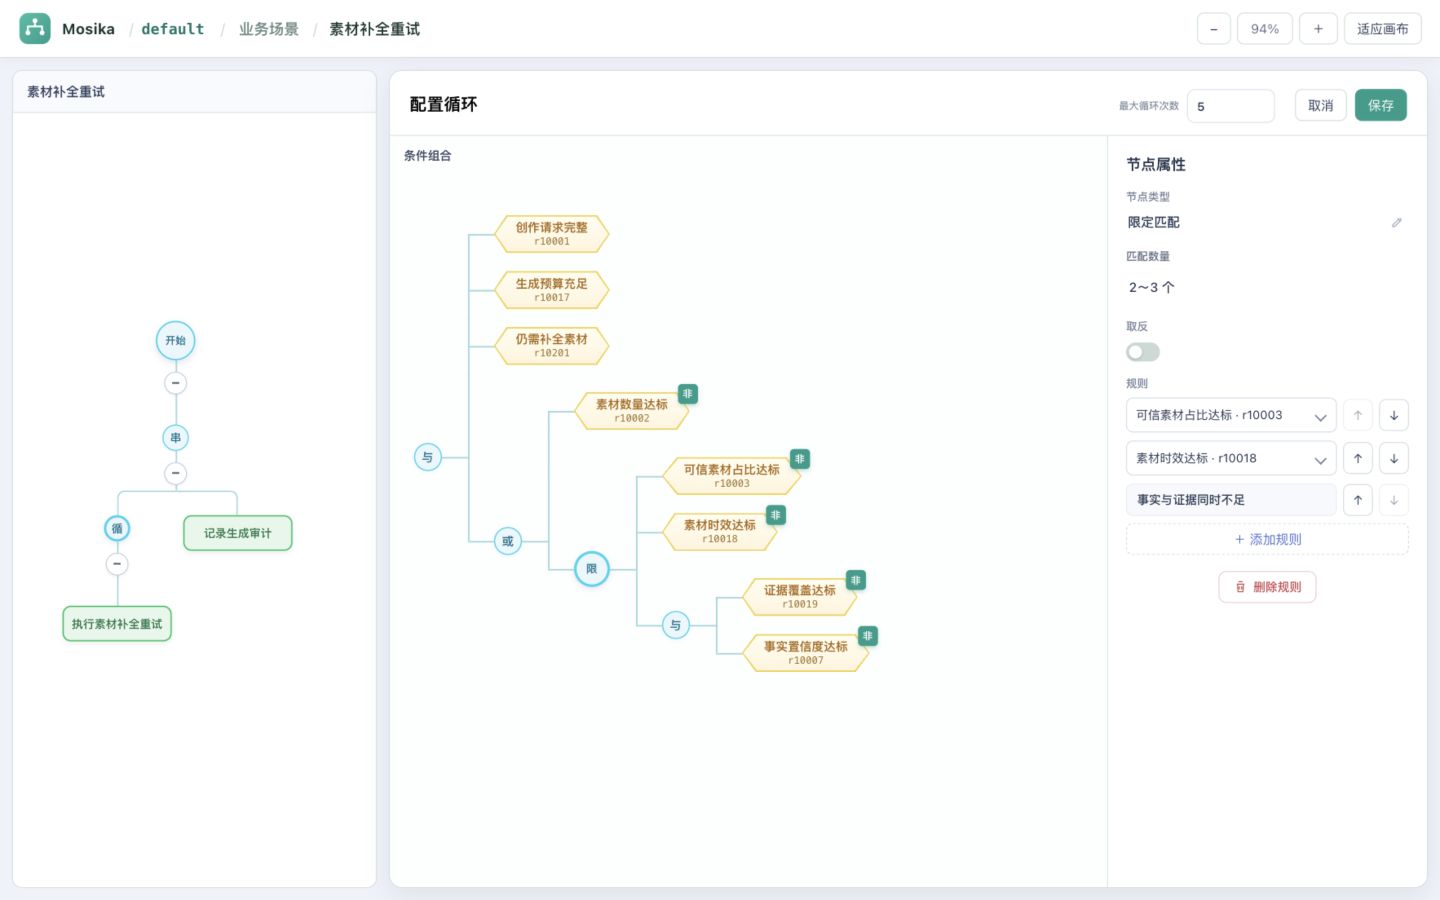
这些结构沿用同一套递归组合规则,复杂条件可以嵌入流程,流程子树也可以继续嵌套串并行与循环。
三、单向编译与执行路径映射
UI AST 是编辑和持久化的事实来源,内核执行树是由它编译得到的另一种表示。
UI 模型保留名称等编辑信息,内核只需要执行语义。两者不必逐节点同构,更不能依靠反向猜测恢复原始编辑结构。
从 UI 树生成内核定义
RuleTreeCompiler 先反序列化 JSON,检查规模与节点结构,再调用 UINodeAdapter.toRule()。编译结果包括规范化 UI JSON、DSL 和引用的规则 ID 集合。产品层保存 UI JSON,并用 DSL 构造 ruleType=2 的复合 RuleDefinition,交给 RuleSuite 装配。
UI 的 AtomicNode 表示引用叶子,不保证被引用定义是 JavaScript 原子规则。原子规则生成 ExprNode,执行时交给 RuleEngine;命名复合规则在构建阶段展开为 CompositeNode,支持前向引用并检测循环引用。这里的递归是结构组合,不是允许命名规则无限递归调用。复合规则使用裸 ID 引用,模板参数应绑定在其内部原子叶子上,外层复合引用不会自动向内传参。
| UI 结构 | 内核表示 |
|---|---|
单个 ActionNode |
解析其 rule.ruleExpr() |
连续 ActionNode.next |
合并为 SerNode |
无后继的 ConditionNode |
条件规则自身 |
有后继的 ConditionNode |
CaseNode(condition, matchedBranch) |
DecisionNode |
按声明顺序组织的嵌套 CaseNode |
SerialNode / ParallelNode |
加入 ∅ 的 SerNode / ParNode |
UI LoopNode(max, rule, next) |
内核 LoopNode(max, condition, action) |
例如,一个包含两个条件与默认分支的 UI 决策节点,会生成 a?b:(c?d:e)。它在画布上是一个“分”节点,在内核中是嵌套的条件节点。这里保持的是选择顺序与分支语义,并非对象或树形结构相同。
结构占位与单向性
UI 串并节点编译时加入 ∅,帮助保留明确的结构。例如:
∅->(a=>b)->c
表示外层串行中包含一组并行,然后执行 c。∅ 不承载业务计算,但作为普通节点参与结构表达。
UINodeAdapter 只提供 toRule()。执行树丢弃了展示名称等元数据,还会合并或展开节点,因此不能从它完整恢复 UI AST。持久化原始编辑模型,可以避免内核结构调整意外改变用户的编辑视图。
高亮来自路径映射
参考 Web 的试运行入口会针对当前 UI 树建立 FlowTraceBuilder,为流程节点生成临时复合规则 ID,同时保存这些 ID 到 UI 路径的映射,例如 $.next.branches[0]。执行后,服务遍历 RuleResult 详情,查出实际访问过的路径,交给画布高亮。
因此,执行详情与 UI 的关联有明确的桥梁。循环多轮访问同一节点时,画布路径列表会去重;每轮访问的细节仍保留在执行详情中,不能仅凭高亮次数判断循环轮数。
下面对同一个 V2 草稿执行测试,输入完整提供它引用的业务字段,初始上下文为空:
{
  "topic": "城市更新",
  "contentType": "ARTICLE",
  "channel": "WEB",
  "remainingTokenBudget": 10000,
  "estimatedTokenCost": 500,
  "requiredSourceRetries": 3,
  "sourceCount": 5,
  "verifiedSourceCount": 2,
  "sourceFreshnessHours": 12,
  "maxSourceAgeHours": 24,
  "claimCount": 10,
  "citedClaimCount": 5,
  "factConfidence": 0.7
}
该输入中素材数量达标,可信素材占比不足,时效达标;证据覆盖和事实置信度同时不足,因此“限”的三个直接子条件恰好命中两项。实际执行 3 轮后,sourceRetryCount=3,r10201 不再命中,循环退出并执行审计动作。根串行节点没有业务返回值,动作阶段对象保留在子节点执行详情中。
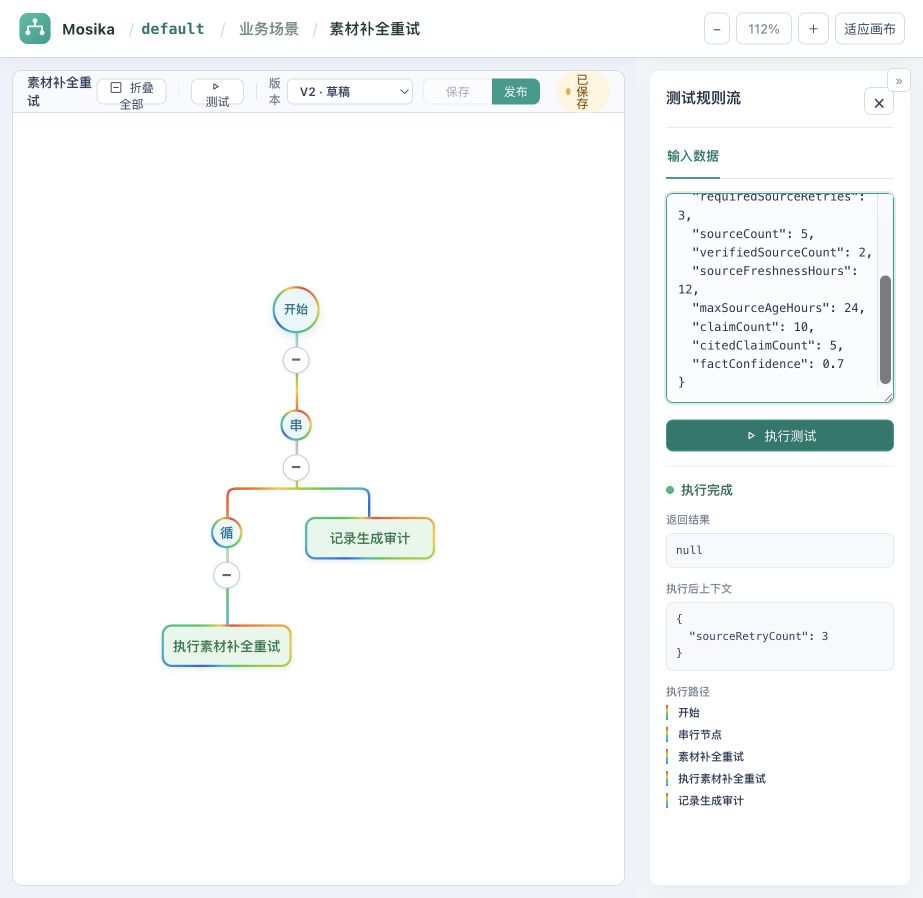
UI AST 提供语义来源,编译映射负责转换结构,追踪映射负责把运行结果关联回来。这三项机制共同支撑编辑、执行与解释的一致性。
四、规则参数:一份逻辑,多处复用
规则定义保存稳定的业务逻辑,节点参数承载不同策略的配置,同一条规则可以在一棵树中按节点独立实例化。
素材校验常常只有门槛不同:基础策略要求至少 3 条素材,严格策略要求至少 5 条。把数量判断写成参数化规则后,两种策略就能共用一份定义。
定义模板,在引用处配置参数
沿用素材校验业务,下面以 sourceEnough 演示参数化写法;它是对前述场景的扩展示例,截图中的 V2 草稿保持原有配置。规则表达式为:
$.sourceCount >= $args.min
其中 $.sourceCount 是本次请求的素材数量,$args.min 是当前节点配置的最低数量。两处引用分别写成:
| 策略节点 | 规则 DSL | 素材数量为 4 时 |
|---|---|---|
| 基础素材校验 | sourceEnough("""{"min":3}""") |
命中 |
| 严格素材校验 | sourceEnough("""{"min":5}""") |
未命中 |
两处节点引用相同的规则 ID,分别持有自己的参数。调整严格策略的门槛,只需修改该节点的 min;更新数量判断的实现,则统一维护 sourceEnough 的规则定义。
可视化模型也沿用这套表达:原子引用节点的 expr 保存规则 ID,args 保存 JSON 参数文本,AtomicNode.ruleExpr() 将两者生成带三引号参数块的 DSL。参数随节点一起保存,从画布配置到内核执行保持同一份含义。
业务输入、执行状态与规则参数各有位置
| 绑定 | 作用范围 | 素材场景中的用途 |
|---|---|---|
$ |
本次顶层执行 | 读取素材数量 $.sourceCount |
$$ |
本次顶层执行及其分支 | 记录重试进度 $$.get("sourceRetryCount") |
$args |
当前原子规则调用 | 读取节点门槛 $args.min |
业务输入描述“当前有什么”,节点参数描述“这条策略要求什么”,执行上下文保存“流程进行到了哪里”。三者分开后,同一输入可以接受不同策略校验,每个节点的参数也有独立归属。
三引号包围 JSON 对象文本,ANTLR 识别参数块边界,ExprNode 在构造阶段一次性解析参数。执行时,RuleEngine 将参数对象绑定为 $args,同一份预编译脚本便能接受不同配置,无需为每组参数生成一份 JavaScript 源码。
在复合条件中,参数配置在具体的原子叶子上,命名复合规则通过裸 ID 引用。这样,“与、或、非、限”负责组织条件,各叶子负责自己的业务门槛,组合结构与策略配置可以分别维护。
参数也进入执行解释
规则描述的配置可以读取同一份节点参数:
{"desc": "当前素材数量为 ${$.sourceCount},本节点要求至少 ${$args.min} 条"}
对于素材数量为 4 的输入,两处节点分别生成“本节点要求至少 3 条”和“本节点要求至少 5 条”的说明。执行详情为每次节点访问保留各自的结果与描述,读者能直接看到相同规则在不同配置下的判断依据。
参数化把规则复用落实到了定义、节点配置和执行解释三个环节:逻辑维护一份,策略按需配置,结果逐节点可读。
五、两层之间的执行协作
统一的结果模型与作用域缓存,让业务计算自然接入条件判断、流程推进和执行解释。
业务返回值与命中状态
EvalResult.result 保存业务值,EvalResult.matched 保存控制结构使用的命中状态。原子脚本返回普通值后,内核会按自己的转换规则生成 matched。当前 Rhino 适配层先把普通 JavaScript 数组转为 Java List、对象转为 Map、undefined 转为 null,再计算命中状态,因此下表的集合与映射也对应脚本返回的 [] 和 {}。
| 原子规则返回值 | 默认 matched | 判定方式 |
|---|---|---|
true / false |
原值 | 直接使用布尔值 |
1 / 0 / -1 |
true / false / false | 数字必须大于零 |
"false"、"no"、"null"、"0"、"fail" |
false | 字符串整值匹配,忽略大小写 |
空字符串 "" |
true | 不在上述假值字符串集合内 |
| 空 Collection / Map | false | 集合为空 |
| 非空 Collection / Map | true | 集合非空 |
null |
false | 无返回值 |
这是 Mosika 的规则语义,不能直接套用 JavaScript 的真值转换。金额为负、返回空集合等情形,都可能影响后续分支;条件规则显式返回布尔值通常更容易阅读。
结构节点也可以分别指定这两个字段:
| 节点类别 | 对结果的处理 |
|---|---|
| 与、或、非、命中数节点 | 解释子节点的 matched,产生逻辑结果 |
CaseNode |
执行选中的分支,传递该分支的 result 与 matched |
SerNode / ParNode |
正常完成时返回 result=null、matched=true |
LoopNode |
按条件和上限完成循环,正常返回 result=null、matched=true |
因此,a->b 不会因为 a 未命中就停止;需要按 a 的判断决定是否执行 b,应使用 a?b。未命中是正常业务状态,异常则沿执行调用链传播,不能混成一种结果。
缓存以求值作用域为边界
叶子结果的缓存键由规则 ID 与规范化参数组成:对象字段递归排序,数组保留顺序。相同规则与参数在当前有效作用域内复用结果,不同参数分别求值,循环按轮次刷新。
| 情形 | 缓存行为 |
|---|---|
| 同一作用域重复引用相同规则与参数 | 复用叶子结果 |
| 相同规则、不同参数 | 分别求值 |
| 同一循环轮次的条件与动作 | 共享本轮缓存 |
| 进入下一轮 | 清空本轮缓存,重新求值 |
| 嵌套循环 | 使用独立的轮次作用域 |
| 循环实际发生求值后退出 | 使父作用域缓存失效 |
以素材补全为例,动作修改 $$ 中的计数,下一轮条件必须读取新值。若只按顶层执行缓存,条件就会反复拿到第一轮的判断。
这种复用也覆盖动作规则:同一有效作用域内,相同规则与参数的重复引用复用叶子结果,每次访问仍保留独立的执行详情。需要逐轮推进状态的动作放在循环中,由轮次作用域保证重新求值。
参数结果缓存复用一次求值的结果,脚本编译缓存复用 JavaScript 编译产物。两者配合,既保留各节点的策略配置,也减少重复编译和同一作用域内的重复计算。
六、选择 Rhino,让计算引擎易于替换
此次升级结合压测实验进行综合评估后,将底层计算引擎从 GraalJS 切换为 Rhino,并通过集中的引擎适配保留后续替换的灵活性。
规则编排围绕规则 ID 和内核节点展开,JavaScript 负责具体计算。Rhino 在这套设计中提供脚本编译、求值和 Java 互操作能力,规则作者可以使用对象、函数与 UDF 表达业务逻辑,编排层则继续使用同一套递归树模型。
四个入口集中引擎绑定
原子规则、临时表达式和动态描述分别经 evalRule、evalExpr、evalRuleDesc 求值,最终进入同一个委托入口:
private Object doEval(Object script, Object root, Object ruleContext,
                      Map<String, Object> arguments) {
    return RhinoEngine.evaluate(script, udfScope, root, ruleContext,
            arguments == null ? Map.of() : arguments);
}
除了求值,脚本编译、UDF 共享作用域和线程上下文也各有入口:
| 入口 | 职责 |
|---|---|
evaluate |
绑定业务输入、上下文和节点参数,执行脚本并转换返回值 |
compile |
编译规则表达式与动态描述,供后续执行复用 |
sharedScope |
创建 UDF 共享作用域,提供已注册的函数能力 |
inContext |
管理线程执行上下文,供一次求值中的多段脚本使用 |
具体到代码,Rhino 的直接引用集中在 RuleEngine 以及 engine/rhino/ 下的 RhinoEngine、JsUdf、JavaUdfFunction。结构节点、套件装配与 UDF 定义容器保持独立,使引擎适配有明确的落点。
编译一次,按节点绑定数据
RuleEngine 构造时预编译已注册的原子规则与描述,临时表达式也按源码缓存。每次求值创建独立子作用域,绑定 $、$$、$args,并通过原型读取 UDF 共享作用域。
这与规则参数化直接配合:sourceEnough 的判断逻辑只需编译一份,基础校验和严格校验分别绑定各自的 min。脚本编译产物得到复用,规则顶层变量在各次求值的子作用域中分开,UDF 能力则统一注册、重复调用。
GraalJS 的替换集中在适配层
后续需要使用 GraalJS 时,可以沿这四类职责提供对应实现,并为 Java 与 JavaScript UDF 接入相应的绑定回调。输入仍通过 $、$$、$args 传入,输出仍交给统一的结果模型,结构层继续使用原有的 DSL 与递归节点。
这让替换工作集中在脚本运行和函数绑定上:流程编排模型、条件组合方式、规则参数表达以及 UDF 分组与注册模型都可以继续复用。Rhino 是当前的计算实现,双层语言设计则让引擎选择拥有持续演进的空间。
七、UDF:业务能力复用与引擎绑定分离
UDF 定义容器保持引擎中立,编译回调负责生成具体引擎可调用的对象。
定义树与编译结果分开
UdfDefinition 用三个字段描述扩展函数:
| 字段 | 含义 |
|---|---|
group |
可选分组路径,例如 content.generation |
name |
注册名称 |
udf |
Java 对象或 JavaScript 源码字符串 |
UdfContainer 保存嵌套 Map 与原始定义。编译时传入 UdfCompiler,由它创建分组、编译叶子、绑定成员并完成收尾。容器负责遍历结构,回调负责表示与绑定。
定义树和遍历协议保持引擎中立,绑定回调将它们转换为具体引擎的分组对象与可调用函数。当前回调生成 Rhino 对象;适配 GraalJS 时,复用同一份定义与注册模型,为它提供对应的绑定实现即可。
用统一名称调用业务能力
Java 与 JavaScript UDF 都通过注册名调用,分组形成命名空间。例如:
sys.num.divide("0.1", "0.2", 2)
sys.coll.sum($.amounts)
前者用字符串参数把十进制输入交给 Java 数值能力;后者把业务集合传给内置函数。新增业务 UDF 不需要修改编排语法。
Java UDF 通过 @UdfMethod 暴露 public 实例方法,统一代理负责参数转换,并按方法名与形参个数分派:优先匹配定长签名,再匹配可用的 varargs。业务函数可以接收集合、映射和执行上下文,让既有 Java 能力直接参与规则计算。
JavaScript UDF 通过显式入参接收业务数据与策略配置。沿用素材数量校验,把可复用的比较逻辑提取为函数后,原子规则可以这样调用:
// 注册为 materialAtLeast 的 JavaScript UDF 源码
(count, min) => count >= min

// 原子规则中的调用
materialAtLeast($.sourceCount, $args.min)
规则定义负责选择函数,节点参数提供策略配置,UDF 封装可复用的计算能力。新增业务函数沿用注册机制,切换计算引擎沿用定义模型,两类扩展各有入口。
八、让规则成为可持续积累的业务资产
双层语言设计的价值,是让业务逻辑可以复用、复杂策略可以组合、计算实现可以独立演进。
在素材补全场景中,规则库沉淀输入校验、预算判断和素材质量检查;复合条件把这些能力组织为多层策略;循环节点负责逐轮推进;试运行把实际访问路径和判断结果带回画布。参数化则让同一份校验逻辑服务不同门槛的策略。
| 设计选择 | 带来的价值 |
|---|---|
| 规则 ID 引用 | 将业务计算沉淀为独立维护、反复组合的规则单元 |
| 节点参数化 | 一份逻辑适配多种策略,参数与执行解释逐节点对应 |
| 递归树编排 | 用嵌套子树统一表达与或非、命中数、分支、串并行和循环 |
| UI AST 单向编译与路径映射 | 贯通可视化编辑、内核执行和结果解释 |
| 脚本编译复用与作用域结果缓存 | 复用稳定计算产物,减少重复编译与求值 |
| 集中的引擎绑定 | 当前使用 Rhino,后续可通过局部适配替换 GraalJS |
| 引擎中立的 UDF 定义 | 复用 Java 与 JavaScript 业务函数,扩展能力沿用统一注册方式 |
当策略从一条流程增长为一组相关场景时,这种分工让新增配置继续使用已有规则,让新增业务能力继续接入已有编排,也让计算引擎的演进集中在适配层。规则积累得越多,可直接组合与复用的业务能力就越丰富。